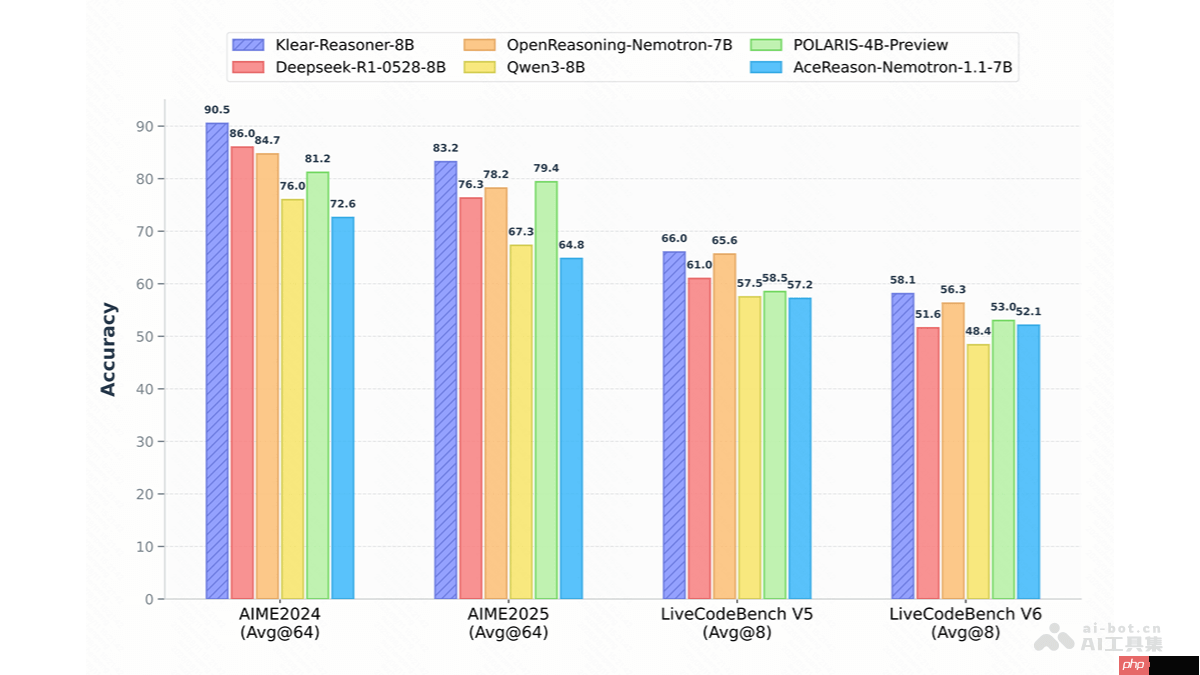
Klear-Reasoner 是由快手团队开发的一种基于 Qwen-base 模型的推理优化系统,专注于提升数学解题和代码生成能力。该模型通过长思维链监督微调(Long Cot SFT)和强化学习(RL)策略进行训练,并引入了名为 GPPo 的新型优化算法。GPPo 算法通过保留传统裁剪操作中被丢弃的梯度信息,解决了传统方法探索能力和负样本收敛速度上的问题,在 AIME、LiveCodeBench 等权威评测中取得了显著效果,目前在 规模模型中的表现领先业界。值得一提的是,Klear-Reasoner 的完整训练流程与技术细节均已公开,为后续推理模型的研究和复现提供了宝贵的参考。
AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型
 Klear-Reasoner的核心功能
面对复杂的数学问题,我的表现尤为出色。我能够处理各种高难度的竞赛题目,并展示出极强的逻辑推理和多步演算能力。在我应对编程任务时,也显示了不俗的实力。我在LiveCodeBench VV试中分别取得了和的准确率,充分证实了其在程序设计中的实用性。为了进一步提升模型性能,我引入了长思维链监督微调与强化学习机制,这显著增强了我的连贯性和准确性,在处理多阶段、长链条推理任务时表现尤为突出。我也采用了高质量数据训练策略,优先选择高可信度的数据源来减少噪声干扰,并保留部分错误样本以增强模型在复杂场景下的探索和纠错能力。
Klear-Reasoner的底层技术架构
长思维链监督微调(Long CoT SFT):利用高质量、结构清晰的思维链数据进行监督训练,确保模型掌握正确的推理路径。精选少数优质数据源,避免低质数据污染模型学习过程。同时,有选择地保留部分错误样本,特别在高难度任务中,提升模型的试错与探索潜力。强化学习优化(RL):在监督微调基础上引入强化学习,进一步提升模型在数学与编程任务中的推理表现。采用软奖励机制,根据测试用例的通过比例给予梯度反馈,有效缓解奖励稀疏问题,提高训练稳定性。GPPO算法:针对传统 PPO和 GRPO 中因梯度剪裁导致高熵 token 梯度丢失、探索受限的问题,GPPO 创新性地将剪裁操作与反向传播解耦。通过 stop-gradient 机制,保留所有 token 的梯度信息:对高熵 token 限制梯度范围以维持探索,对负样本 token 保留梯度并控制更新幅度,从而加速错误纠正过程。软奖励机制设计:在代码生成任务中,采用基于测试用例通过率的连续型奖励(软奖励),相比传统的“全有或全无”硬奖励,能提供更密集的训练信号,降低梯度方差,使模型学习更加平稳高效。
Klear-Reasoner的开源资源
GitHub 项目地址:https://www.php.cn/link/a1ff59c9fcd256be3695bb06465e1011 HuggingFace 模型页面:https://www.php.cn/link/340906ef68f7888651490d4b3798ec70 arXiv 技术论文链接:https://www.php.cn/link/4c1f53116d73ff13367ffbfd35d8a105
Klear-Reasoner的实际应用方向
未来教育的智能助手:虚拟数学教师、代码编程伙伴、金融决策专家及个性化客服在未来的科技浪潮中,我们迎来了智能教育辅助工具的新纪元。这些技术不仅提升了学习效率,更是革新了传统教学方式,为学生提供了前所未有的学习体验。作为虚拟数学导师,我们的智能系统能够深入解析每一个数学问题,提供详尽的解题思路与分步推导。这样不仅能帮助学生快速理解抽象概念,还能够在关键时刻点亮学习灯塔,引导他们找到正确的方向。在程序开发领域,我们提供自动代码编写、函数生成和逻辑补全功能。开发者只需专注于创意设计,我们的系统将承担繁琐的编码任务,不仅大大加速了构建功能模块的过程,还时刻提醒开发者潜在错误,为他们的项目保驾护航。金融分析师们通过严谨的数据建模与风险预测工具来制定投资策略和市场趋势判断。我们应用了复杂逻辑推理,帮助分析师精准把握数据背后的趋势,做出明智的投资决策。科研人员在进行复杂的科学计算与数据分析时不再孤单。我们的系统为他们提供可解释的分析路径,加速实验设计与结果验证过程。无论是研究者还是学生,在面对大量数据和复杂问题时,我们都提供了可靠的解决方案。最后,智能客服系统是教育行业的全新突破。我们开发了一套能够处理用户复杂咨询问题的服务平台。结合清晰的推理过程,我们的智能客服不仅能给出精准回答,还能够在关键时刻提供指导建议,提升服务质量和用户体验。让我们一起迎接这个充满希望和挑战的新时代吧!
以上就是Klear-Reasoner 快手开源的推理模型的详细内容,更多请关注其它相关文章!
相关文章
-
- 快手极速版2026最新版10-16
- 快手小说10-15
- 捕快手记10-15
- 快手极速版10-09
- 快手磁力金牛查看方法10-07
- 快手如何找Office办公课10-06
- 快手红包挂件隐藏了怎么办啊(快手红包挂件恢复方法分享)09-29
- 关闭截屏分享方法介绍-快手极速版怎么取消截图后弹出快捷分享和反馈09-26
- 快手小店商家版如何报名参加活动 快手小店商家版报名参加活动方法09-21
- 快手中找到K歌的详细图文讲解09-21
- 快手怎么激活免流量?快手激活免流量操作介绍09-16
- 快手怎么注销账号?-快手注销账号教程09-09
- 快手头像国旗如何设置09-02
- 快手私信如何彻底删除陌生人消息09-02
- 快手私信如何全部删除09-02
- 2026热门快手小游戏推荐:免费好玩的快手手游合集09-01
- 快手下载入口地址最新08-27
- 快手极速版怎么设置繁体字-快手极速版设置繁体字的方法08-24
- 如何彻底关闭快手小店?彻底关闭快手小店操作教程08-22
- 快手极速版app怎样升级08-21
- 快手心情状态怎么关闭好友(快手心情状态取消方法介绍)08-19
- 小编推荐
- 热门推荐
- 最新更新
-
-
- 相关下载
-
-