通过融合视觉、语言和自然语言处理技术的多模态大模型(mllm),可以在静态图像中实现精准的文字识别与理解,展现其卓越OCR能力。
不过,当应用范围扩展到动态视频时,即使是当下最先进的模型也遇到了巨大的难题。
MME-VideoOCR 致力于全面评估并促进 MLLM 在视频 OCR 方面的感知、理解和推理能力。
主要贡献包括:
构建细致的任务体系:
精心规划了10 大任务类型,并进一步细分出25 个独立任务。
评价维度超越基础识别,深入考察时序理解、信息整合及复杂推理等高级能力。
高质量、大规模的数据集:
包含1,464 个精选视频片段,涵盖了不同分辨率、时长与场景。
构建了2,000 条高质量、经人工标注的问答对,保证评测的准确性。
揭示当前 MLLM 的能力边界与限制:
对包括闭源与领先开源模型在内的18 个主流 MLLM 进行了深入评测。
系统分析了各模型在不同视频 OCR 任务中的表现,明确了它们的优势和亟需改进的地方。
即使 Gemini-Pro 等顶级模型,其准确率也仅达到 ,表明当前 MLLM 在视频 OCR 领域面临重大挑战。
研究背景
视频相较于静态图像而言,其信息密度更高且场景更为复杂,因此对OCR任务的难度更大。
动态元素的复杂性是导致MLLM在处理视频文字识别任务中遇到的挑战的主要原因。
视频中的文字信息形式多样,常见于画面主体、背景场景以及屏幕注释、水印和弹幕等形式。为确保模型能有效处理这些分散且时间跨度各异的信息,须建立稳定的时空视觉-文本关联机制,准确识别并整合这些分布在不同位置与时间段的文字内容。
MLLM不仅需精准识别视频中文字,并在视觉和时间上下文复杂场景下进行语义解析与推理,实现对视频深层次理解。
当前,模型语言对(MLLM)在视频OCR领域的表现令人印象深刻。然而,这一技术的核心局限在于对文本上下文理解的挑战和处理复杂场景的能力不足。为了系统地评估并促进其进步,需要深入研究这些局限性,并开发出更高效的方法来应对新出现的问题。
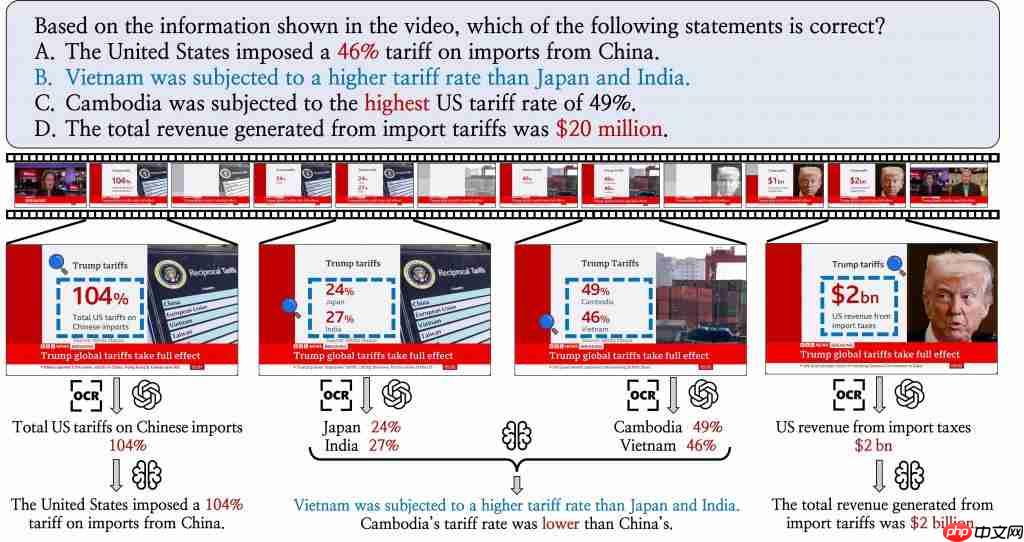
MME-VideoOCR 评测框架详解
MME-VideoOCR的设计专注于全面性与深度,以评估模型在“看到”到“理解”视频文字信息全过程中表现的能力。
数据构建
MME-VideoOCR 的数据集来源于部分高质量数据集和人工采集与构造,经过精心筛选与处理,确保其:
多样性:
涵盖生活记录、影视娱乐、教育科普、体育赛事、游戏直播等多元化场景。
挑战性:
融合真实世界中的运动模糊、低分辨率、复杂背景、艺术字体、文字遮挡和多语言混合的挑战。
时序性:
精心设计了需跨帧理解与追踪动态文本、整合时序信息的任务,彰显模型在动态处理上的强大能力。
随着短视频、弹幕视频和AIGC视频的广泛使用,MME-VideoOCR也增添了对这类特殊视频的支持,以增强数据的全面性和多样性。
共收集1,464 个视频和2000条样本。
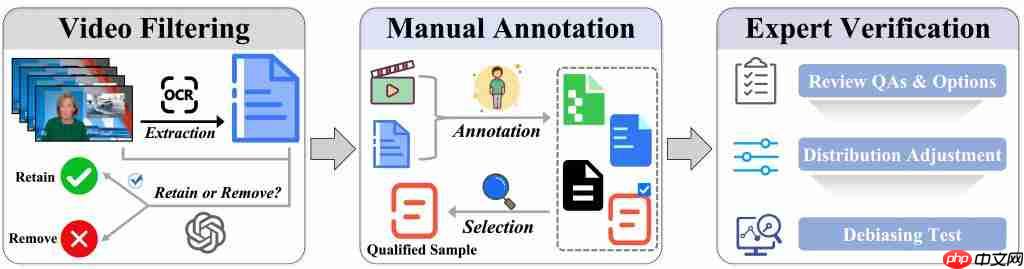
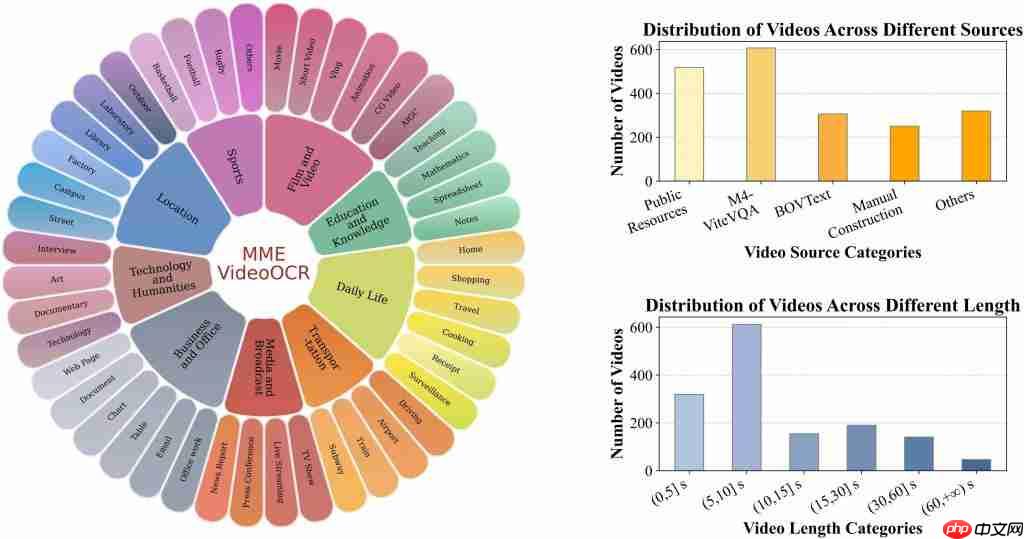
任务设计
十个主要任务类别和二十五个子任务紧密围绕视频OCR的核心挑战,重点评估模型在识别、分割、检索等多个方面的能力。
基础识别:
在各种视频条件下准确识别文字及其属性。
时空定位:
识别文字在视频中的时间、空间位置。
时序追踪:
理解文字内容随时间的演变。
特殊文本解析:
对表格、图表、文档、公式、手写体等特殊文本进行有效解析。
信息整合:
结合视频上下文与文字进行综合理解。
场景理解:
在特定视频情境下解读文字的深层含义。
复杂推理:
基于视频中的文字信息进行逻辑判断与问答。
模型鲁棒性:
对于 AIGC、对抗样本和超长视频的有效理解。

评估策略
针对各种任务特性和潜在的解答灵活度,采用了字符串匹配、多项选择和GPT辅助评分等方法进行评估。
实验发现总结
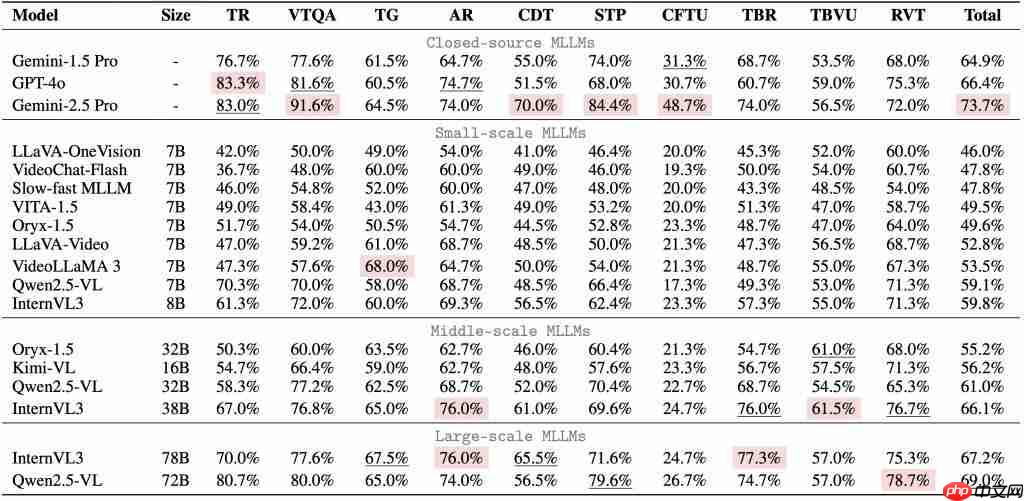
通过对 18 个主流 MLLM 的深度评测,MME-VideoOCR 揭示了以下关键发现:
整体性能:提升空间巨大
顶尖模型面临挑战:
Gemini-Pro 大显身手,然而其 的准确率显示即使是当前最佳模型,在处理复杂视频 OCR 任务时仍存在较大提升空间。
开源模型差距显著:
当前许多开源的MLLM在视频OCR任务中的表现远逊于顶级的闭源模型,其准确性通常低于。
能力短板:时序与推理是关键瓶颈
静态易,动态难:
模型在处理短时间内文字时表现优异,但面对长时间和复杂文本动态不易准确理解和整合。
时空推理能力薄弱:
要求结合文字内容及其时空信息进行推理的任务,是当前 MLLM 的普遍弱点。
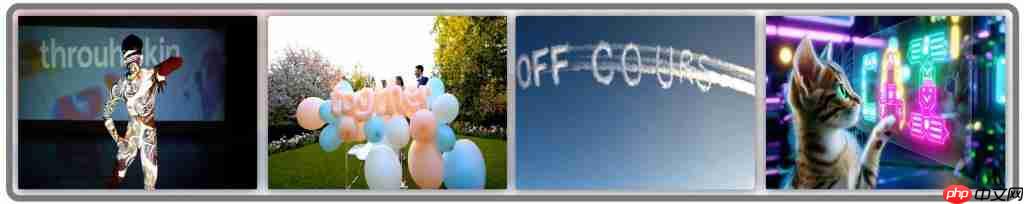
语言先验依赖问题:模型在处理视频文本理解时,易过度依赖语言模型的预设知识,忽视了视觉数据的重要性。
优化关键:高分辨率与时序信息
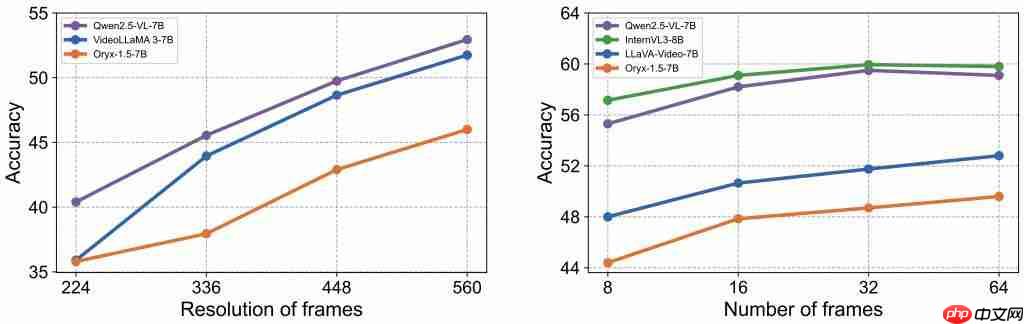
研究表明,提高图像质量和完整帧覆盖对增强 MLLM 在动态视频中的OCR效果至关重要。
在训练深度学习模型时,还需要关注到过多的感官输入可能会影响其专注度并降低预测精度。这不仅提升了模型对数据的分析能力和效率,还强化了其信息识别和决策过程。
论文地址:https://www.php.cn/link/21b6529de735e29783012ab4f9ce604d
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
完
点亮星标
科技前沿进展每日见
以上就是全面评估多模态模型视频 OCR 能力,Gemini 准确率仅 73.7%的详细内容,更多请关注其它相关文章!
相关文章
- 小编推荐
- 热门推荐
- 最新更新
-
-
- 相关下载
-
-