最近收到不少关于Python处理CSV文件数据的求助,这里整理了具体步骤和方法,涵盖了常用操作和技巧,便于大家更轻松地掌握数据处理流程,提升工作效率。以下是操作指南,希望能够帮助到有需求的人。
首先,使用pandas读取CSV文件,生成DataFrame。接着,将DataFrame转换为Python对象,编写数据清洗或分词等处理函数,提升预处理与分析效率与准确性。
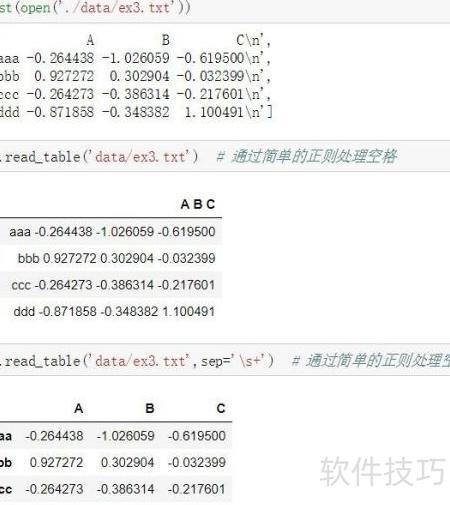
调用处理函数获取新数据,合并原始CSV内容并输出至新的CSV文件中。
例如查看首行全部列的数据,并对每行特定列执行相应操作。
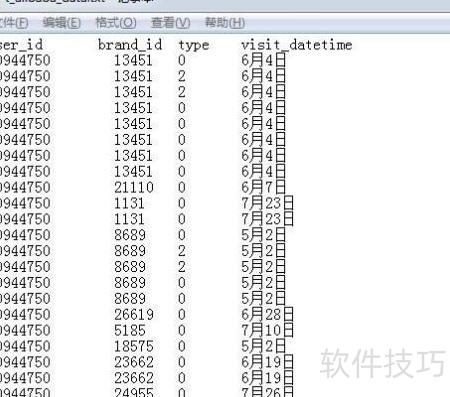
首先,打开CSV文件并检查其编码格式,确保是UTF-接着,使用pandas中的read_csv函数读取数据,初步了解数据整体情况。通过data.describe,可以获取统计信息,包括记录总数(count),本数据中共有。
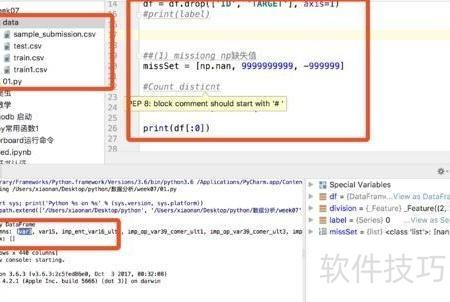
在处理包含多行数据的CSV文件时,首先将DataFrame转换为Python对象是一个基本步骤。假设你有一个名为sermon_df.csv的文件,它包含数据。接下来,你需要对每一行进行处理,提取特定字段,比如comment,以便进行更详细的数据分析和处理。这是你接下来需要执行的操作。
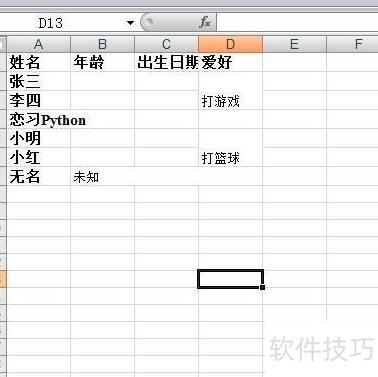
接着遍历数据框的每一行,需首先确定总行数。通过data.describe可知当前有,但对于任意CSV文件,必须能动态获取其记录总数(record_num),以确保处理过程具备通用性和自动化能力,适应不同规模的数据文件。
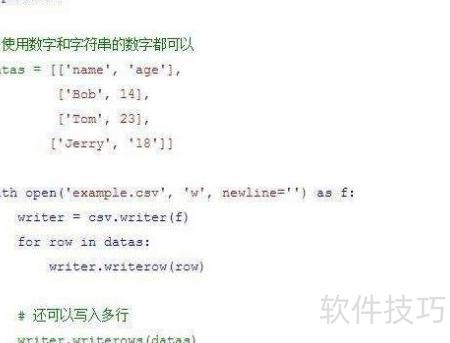
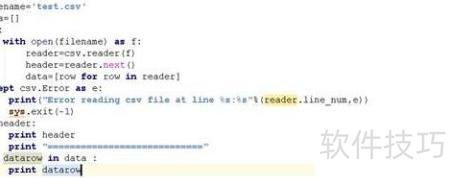
以提取第一行的comment为例,通过数据处理函数筛选并保留中文内容,然后检查生成的CSV文件,确保comment列已按要求清理,仅保留中文文本信息。
相关文章
-
- Photoshop CS5如何把图片转换成PDF文件10-17
- 单机cs手机版安卓版10-06
- Win7启动MMCSS服务方法10-02
- Adobe Illustrator CS6如何绘制加号系列图标10-02
- PS CS4方格碎边纸张字教程09-28
- Barco GRAPHICS 1209s投影机指南09-27
- 网卡是否支持iSCSI?一招教你检测09-27
- Flash CS3安装指南09-17
- Photoshop CS5马赛克使用技巧09-15
- Adobe Premiere Pro CS6怎么更换背景色以及Adobe Premiere Pro09-12
- Adobe Premiere Pro CS6如何编辑滚动字幕-Adobe Premiere Pro09-12
- CSV文件修改后如何保存09-11
- iSCSI服务器与客户端部署08-30
- Photoshop CS4框选工具详解08-25
- 最新更新
- 小编推荐
- 热门推荐
- 最新更新
-
-
- 相关下载
-
-